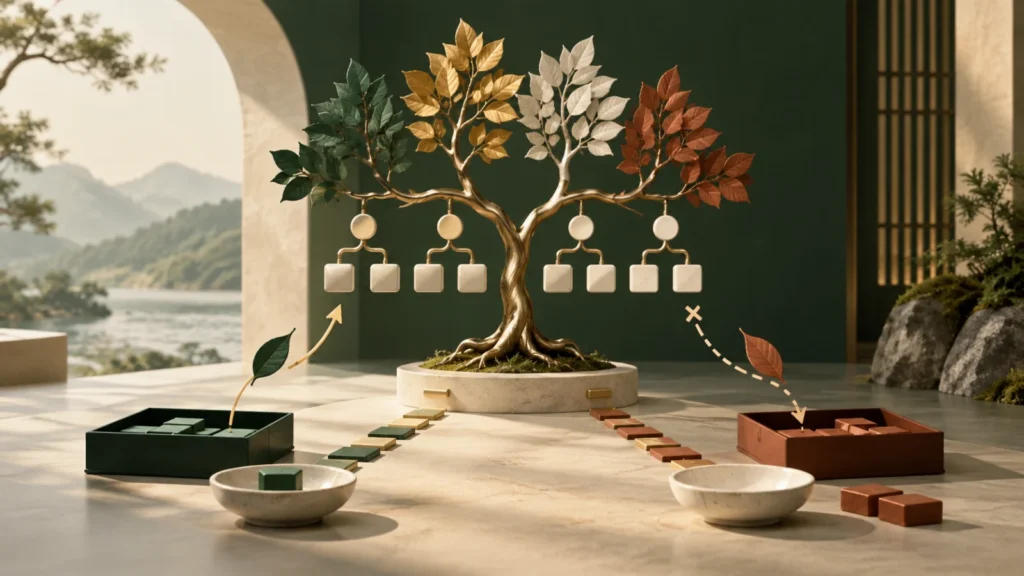
Namespaced Merkle Tree는 각 leaf의 데이터 앞에 namespace ID를 붙이고 leaf를 namespace 순으로 정렬하며, 내부 node hash에 하위 namespace의 최소·최대 범위를 포함합니다. 그래서 특정 롤업은 자신의 연속된 shares와 경계 proof만 받아 root에 포함됐는지, 같은 namespace의 일부가 빠지지 않았는지 확인할 수 있습니다. 이 증명은 블록 전체 데이터가 네트워크에서 가용하다는 DAS 판단과는 별개입니다.
일반 Merkle root에 namespace 범위를 더한다
일반 Merkle tree는 leaf와 sibling hash로 어떤 데이터가 root 아래 포함됐음을 효율적으로 증명합니다. 그러나 특정 앱의 데이터가 여러 leaf에 흩어져 있을 때 제공자가 일부만 골라 주면, 단순 inclusion proof 여러 개만으로 ‘이것이 전부’라고 확인하기 어렵습니다. Celestia는 shares를 namespace ID 순서로 배치하는 NMT를 사용합니다.
각 내부 node는 digest와 함께 하위 leaf의 최소·최대 namespace 범위를 커밋합니다. 검증자는 자신의 namespace shares 양쪽 경계 node 범위를 보고 같은 namespace가 숨겨질 공간이 없는지 확인할 수 있습니다. 정렬 규칙과 범위 커밋이 완전성 증명의 핵심입니다.
NMT는 데이터가 있는 가지뿐 아니라 같은 이름표 데이터가 더 숨어 있을 수 있는 범위까지 커밋한다.
JOBCOIN 해설
그림은 이 주제의 공통 개념을 단순화한 설명입니다. 아래 항목에서 이 글의 구체적인 조건과 예외를 함께 읽어보세요.
- 일반 Merkle root에 namespace 범위를 더한다
일반 Merkle tree는 leaf와 sibling hash로 어떤 데이터가 root 아래 포함됐음을 효율적으로 증명합니다.
- 포함·완전성·부재는 질문이 다르다
inclusion proof는 특정 share가 NMT root에 포함됐는지 답합니다.
- 행과 열 commitment 구조 안에서 쓰인다
Celestia는 block data를 shares로 나누고 2차원 Reed–Solomon coding으로 확장한 뒤 각 row와 column에 commitment를 만듭니다.
AI로 제작한 개념도 · 실제 가격·거래 내역·통계가 아닙니다.
포함·완전성·부재는 질문이 다르다
inclusion proof는 특정 share가 NMT root에 포함됐는지 답합니다. namespace proof는 연속 구간의 shares와 양쪽 sibling node를 사용해 해당 namespace의 전체 범위를 검증합니다. absence proof는 대상 namespace가 없을 때 인접 범위가 그 ID를 건너뛴다는 사실을 보여 줍니다.
어떤 proof도 원문 의미가 올바르거나 롤업 state transition이 유효하다고 자동 보장하지 않습니다. namespace ID를 가진 bytes가 committed data 안에 있다는 구조적 사실을 확인합니다. 앱은 share 파싱, blob commitment, transaction validity를 별도 규칙으로 검사해야 합니다.
| 증명 | 확인하는 것 | 확인하지 않는 것 |
|---|---|---|
| share inclusion | 특정 share의 root 포함 | 같은 namespace 전체 |
| namespace completeness | 연속 namespace 범위의 완전성 | 전체 블록 가용성 |
| namespace absence | 대상 ID가 정렬 범위에 없음 | 앱이 데이터를 제출했는지 |
| DAS sample proof | 표본 share·commitment 일치 | 롤업 실행 유효성 |
행과 열 commitment 구조 안에서 쓰인다
Celestia는 block data를 shares로 나누고 2차원 Reed–Solomon coding으로 확장한 뒤 각 row와 column에 commitment를 만듭니다. NMT는 namespaced data를 다루는 row 구조와 결합되고, 상위 data root가 row·column roots를 커밋합니다. 앱 proof는 이 여러 층의 경로를 정확한 root까지 이어야 합니다.
proof verifier는 namespace version·ID 길이, share index, row root와 data root의 연결을 확인해야 합니다. base64 bytes를 문자열 namespace처럼 비교하거나 min·max 필드 순서를 바꾸면 잘못된 proof를 승인할 수 있습니다. 공식 라이브러리와 test vector를 재사용하는 이유입니다.
- 요청 namespace의 version과 ID bytes를 정확히 고정한다
- 반환 shares가 namespace 순으로 연속인지 확인한다
- side nodes의 min·max 범위와 digest를 root까지 재계산한다
- row root가 해당 block data root에 포함되는 상위 proof를 검증한다
선택 조회와 데이터 가용성을 섞지 않는다
NMT 덕분에 롤업은 다른 앱의 전체 blob을 내려받지 않고 자신의 namespaced shares를 조회할 수 있습니다. 그러나 제공자가 응답하지 않는다면 NMT 자체가 bytes를 만들어 주지는 않습니다. 블록 전체 데이터가 충분히 공개됐는지는 erasure coding과 data availability sampling, full·bridge node의 제공 경로가 답합니다.
반대로 DAS가 높은 확률로 블록 가용성을 지지해도 특정 앱이 받은 blob이 자신의 namespace 전체인지 NMT proof를 검증해야 합니다. 두 장치는 서로 보완하지만 같은 증명은 아닙니다. 운영 지표도 namespace retrieval 성공률과 DAS sampling confidence를 분리합니다.
롤업 통합은 root 출처까지 기록한다
proof가 맞으려면 검증자가 신뢰하는 canonical block header의 data root와 연결돼야 합니다. 임의 제공자가 준 root에 대해 proof가 일치하는 것만으로 canonical inclusion은 성립하지 않습니다. header의 height·hash·finality 출처를 저장하고 proof bytes와 namespace를 함께 보관합니다.
NMT를 실무에서 읽는 순서는 정렬, 범위, hash 경로, canonical root입니다. 이 네 단계를 통과한 뒤에야 특정 namespace data가 해당 블록 commitment 아래 포함됐다고 말할 수 있습니다. 데이터 영구 보존이나 과거 retrievability는 별도 운영 정책입니다.
자주 묻는 질문
NMT proof가 맞으면 블록 전체 데이터를 받을 수 있나요?
아닙니다. 특정 namespace의 포함·완전성 proof와 전체 블록 가용성은 별도 문제입니다.
일반 Merkle tree와 가장 큰 차이는 무엇인가요?
namespace 순서 정렬과 각 내부 node에 하위 namespace 최소·최대 범위를 커밋한다는 점입니다.
absence proof는 앱이 제출하지 않았음을 증명하나요?
해당 committed block 범위에 namespace가 없음을 보일 뿐, 제출 시도나 외부 처리 사실까지 설명하지 않습니다.
더 깊이 읽기
본문에서 다룬 개념과 확인 절차를 다음 글에서 이어서 살펴보세요.