데이터 가용성 샘플링(DAS)은 블록 데이터를 소거 부호(erasure coding)로 늘려 헤더에 커밋한 뒤, 라이트 노드가 미리 짐작하기 어려운 좌표의 조각(share)과 증명을 여러 번 요청하는 방식입니다. 모든 표본이 올바르게 돌아오면, 생산자가 복구할 수 없을 만큼 데이터를 숨기면서도 계속 표본을 피했을 가능성은 낮아집니다. 그 결과는 수학적 가정과 표본 수에 따른 확률적 신뢰이며, 전체 데이터를 직접 내려받았다는 증명은 아닙니다.
가용성은 커밋만으로 알 수 없습니다
블록 헤더의 머클 루트는 특정 데이터에 대한 약속이지만 그 데이터가 실제로 네트워크에 공개됐다는 사실까지 혼자 증명하지는 않습니다. 생산자는 루트를 만든 뒤 데이터를 일부 참여자에게만 주거나, 복구에 필요한 조각을 숨길 수 있습니다. 실행 노드가 데이터 없이 새 상태를 검증할 수 없다면 이 차이는 곧 안전 문제입니다.
DAS에서는 모든 라이트 노드가 블록 전체를 내려받는 대신 작은 무작위 조각을 요청합니다. 돌아온 조각은 헤더 커밋까지 이어지는 머클 증명으로 검증합니다. 틀린 데이터를 돌려주면 증명이 맞지 않고, 응답을 거부하면 그 표본은 실패 신호가 됩니다.
DAS는 데이터 전체를 봤다는 증명이라기보다, 숨겼다면 무작위 검사에 걸릴 가능성을 빠르게 키우는 절차입니다.
JOBCOIN 해설
그림은 이 주제의 공통 개념을 단순화한 설명입니다. 아래 항목에서 이 글의 구체적인 조건과 예외를 함께 읽어보세요.
- 가용성은 커밋만으로 알 수 없습니다
블록 헤더의 머클 루트는 특정 데이터에 대한 약속이지만 그 데이터가 실제로 네트워크에 공개됐다는 사실까지 혼자 증명하지는 않습니다.
- 소거 부호가 숨김의 문턱을 만듭니다
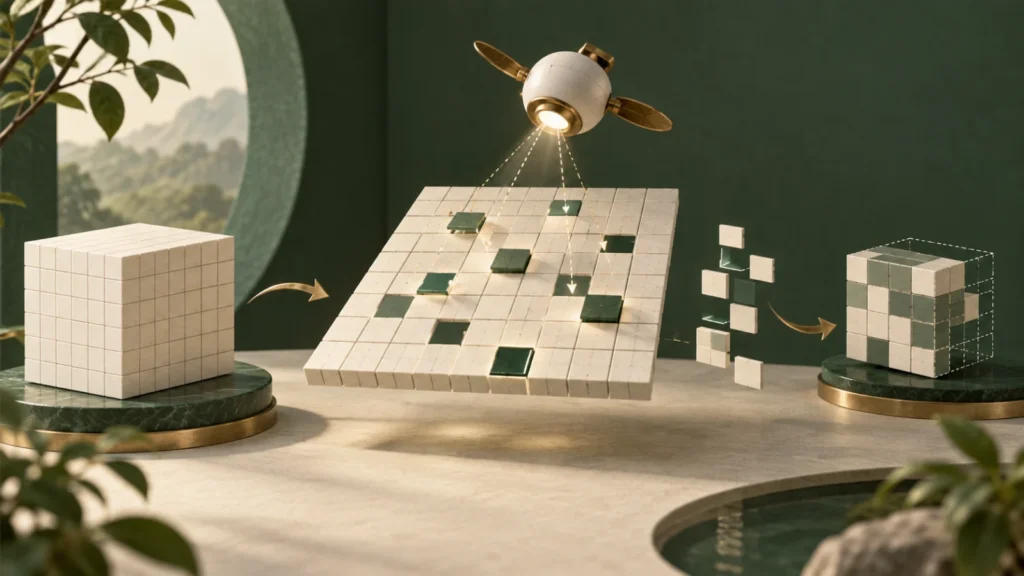
원본에 패리티 조각을 덧붙여 늘려 두면, 일정 수 이상의 조각만 있어도 전체를 복구할 수 있습니다.
- 표본 성공은 세 가지 검사를 통과해야 합니다
첫째, 요청한 좌표의 조각 데이터를 받아야 합니다.
설명을 위한 개념도 · 실제 가격·거래 내역·통계가 아닙니다.
소거 부호가 숨김의 문턱을 만듭니다
원본에 패리티 조각을 덧붙여 늘려 두면, 일정 수 이상의 조각만 있어도 전체를 복구할 수 있습니다. 생산자가 데이터를 정말로 쓸 수 없게 만들려면 단 한 바이트가 아니라 복구 문턱을 넘는 만큼의 조각을 숨겨야 합니다. 숨긴 비율이 클수록 무작위 표본 하나가 숨긴 좌표에 걸릴 확률도 커집니다.
가정 예시로, 전체 조각의 절반을 숨겨야 복구가 불가능하고 독립 표본 10개를 뽑는다면 모두 공개된 영역에만 떨어질 확률은 (1/2)^10, 약 0.098%입니다. 설명을 위한 단순 산식일 뿐입니다. 실제 프로토콜은 2차원 부호화, 중복 없는 표본, 여러 노드와 네트워크 실패 모델을 반영하므로 제품이 보여 주는 신뢰도 값을 이 식 하나로 재현하면 안 됩니다.
| 숨김 비율 | 독립 표본 수 | 모두 놓칠 확률 |
|---|---|---|
| 50% | 5 | 3.125% |
| 50% | 10 | 약 0.098% |
| 25% | 10 | 약 5.63% |
| 25% | 20 | 약 0.317% |
표본 성공은 세 가지 검사를 통과해야 합니다
첫째, 요청한 좌표의 조각 데이터를 받아야 합니다. 둘째, 그 조각의 머클 증명이 행 또는 열 커밋에 맞아야 합니다. 셋째, 그 커밋이 검증된 정식 헤더에 속해야 합니다. 아무 API가 준 신뢰도 숫자만 저장하면 어느 헤더와 어떤 표본을 검증했는지 다시 확인할 수 없습니다.
응답 시간 초과만으로는 악의적인 데이터 은닉과 일시적인 피어 장애를 바로 구분할 수 없습니다. Celestia 문서도 실패한 샘플링 요청에서 거짓 음성을 고려해 재시도하는 방식을 설명합니다. 그러나 끝없는 재시도로 실패를 덮으면 경보가 의미를 잃습니다. 피어 교체, 횟수를 정한 재시도, 실패율과 응답 시간을 함께 기록합니다.
- 정식 헤더 해시와 데이터 커밋을 먼저 확정합니다
- 표본 좌표를 짐작하기 어렵게 고르고 중복 여부를 기록합니다
- 조각 데이터와 머클 증명을 로컬에서 검증합니다
- 시간 초과·잘못된 증명·피어 오류를 구분하고, 정해진 횟수만큼 재시도한 뒤 멈춥니다
라이트 노드가 많으면 함께 복구하는 데도 보탬이 됩니다
라이트 노드 하나하나는 작은 표본만 받지만, 서로 다른 좌표를 샘플링하고 유효한 조각을 주고받으면 전체적으로 충분한 고유 조각을 모을 수 있습니다. 정직한 브리지 노드가 이를 모아 전체를 복구할 가능성도 커집니다. 그래서 노드 수뿐 아니라 표본의 다양성과 네트워크 연결이 중요합니다.
같은 중앙 제공자와 같은 좌표 묶음에 기대면 노드가 많아도 독립성은 약합니다. 샘플링 무작위성, 피어 다양성, 고유 좌표 수를 운영 지표로 봅니다. ‘10만 노드’ 같은 숫자만으로 실제로 함께 덮는 범위를 짐작하지 않습니다.
가용성과 영구 보존은 서로 다른 약속입니다
DAS가 블록 생성 시점의 데이터 공개를 높은 확률로 뒷받침하더라도, 몇 년 뒤 모든 과거 블롭을 같은 노드가 내준다는 뜻은 아닙니다. 데이터 정리(pruning), 샘플링 기간, 보관 정책이 과거 데이터를 다시 받을 수 있는지를 정합니다. 롤업은 자체 데이터 보관자와 복구 계획을 마련해야 합니다.
또한 DAS는 거래가 유효하다거나 상태 전환이 올바르다는 유효성 증명이 아닙니다. 공개된 데이터를 실행하고 검증할 책임은 상위 프로토콜에 남습니다. 커밋, 가용성, 유효성, 보존을 네 열로 나누면 지표 하나를 지나치게 해석하는 일을 막을 수 있습니다.
자주 묻는 질문
표본이 모두 성공하면 100% 가용한가요?
확률적 보장입니다. 표본 수와 부호화·공격 가정에 따라 거짓 양성 가능성이 매우 낮아지지만, 0이라고 단정하지는 않습니다.
Merkle root만 있으면 데이터 가용성을 알 수 있나요?
아닙니다. 루트는 데이터에 대한 커밋일 뿐이며, 실제로 공개되고 응답하는지는 샘플링이나 전체 내려받기로 확인합니다.
DAS는 과거 데이터를 영구 보관하나요?
아닙니다. 과거 데이터를 다시 받을 수 있는지는 데이터 정리·보관 정책과 별도 보관 주체에 달려 있습니다.
더 깊이 읽기
본문에서 다룬 개념과 확인 절차를 다음 글에서 이어서 살펴보세요.