체결 API는 ‘다음 페이지’라는 말만 믿고 이어 붙이면 안 됩니다. 먼저 정렬 방향, 커서가 가리키는 행의 포함 여부, 한 페이지의 최대 건수, 체결 ID의 연속성 보장을 확인해야 합니다. 저장 단계에서는 시장 식별자와 체결 ID를 기본키로 중복을 제거합니다. 시간 커서만 제공될 때는 같은 밀리초의 마지막 행을 놓칠 수 있으므로 경계를 겹쳐 다시 요청하고 고유키로 합친 뒤, 요청 구간의 시작·끝과 페이지별 최소·최대 키를 검산해야 합니다.
커서 이름은 방향을 보장하지 않습니다
Coinbase Exchange의 product trades 문서는 `before`를 시작 커서, `after`를 끝 커서로 설명하고 기본 응답은 최신 체결 목록입니다. 반면 다른 API의 `fromId`는 지정한 ID 이상을 오름차순으로 돌려줄 수 있습니다. 이름이 비슷해도 ‘과거로 이동’과 ‘미래로 이동’이 반대일 수 있으므로, 첫 응답의 첫·마지막 ID와 다음 요청 결과를 나란히 기록해야 합니다.
검증용으로 결과가 계속 늘어나는 최신 구간 대신 이미 끝난 짧은 과거 구간을 택하세요. 첫 페이지가 5100, 5099, 5098 순서라면 커서 5098을 넣은 다음 페이지가 5097부터 시작하는지, 5098을 다시 포함하는지 확인합니다. 이 한 번의 경계 실험이 문서 해석과 실제 동작이 맞는지 보여 줍니다.
페이지네이션의 핵심은 페이지 번호가 아니라 마지막으로 확정 저장한 레코드 다음을 증명하는 일입니다.
JOBCOIN 해설
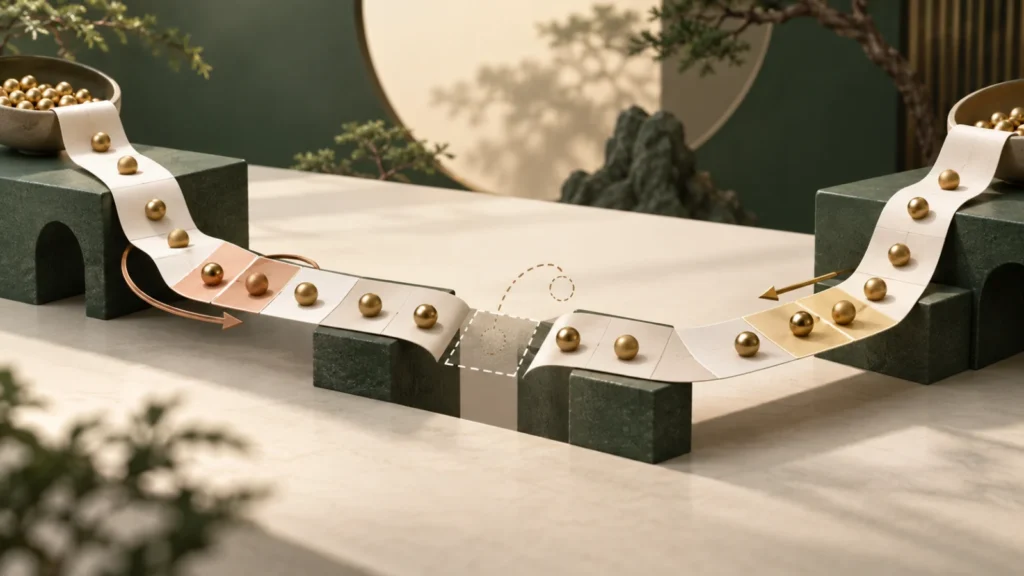
그림은 이 주제의 공통 개념을 단순화한 설명입니다. 아래 항목에서 이 글의 구체적인 조건과 예외를 함께 읽어보세요.
- 커서 이름은 방향을 보장하지 않습니다
Coinbase Exchange의 product trades 문서는 `before`를 시작 커서, `after`를 끝 커서로 설명하고 기본 응답은 최신 체결 목록입니다.
- 포함 경계는 한 행 중복과 한 행 누락을 가릅니다
가정 예시로 API가 `fromId=100`일 때 100을 포함해 100, 101, 102를 반환한다고 합시다.
- timestamp 하나로는 같은 순간의 체결을 셀 수 없습니다
한 밀리초에 체결이 여러 건 생길 수 있습니다.
AI로 제작한 개념도 · 실제 가격·거래 내역·통계가 아닙니다.
포함 경계는 한 행 중복과 한 행 누락을 가릅니다
가정 예시로 API가 `fromId=100`일 때 100을 포함해 100, 101, 102를 반환한다고 합시다. 다음 요청을 마지막 ID 102로 보내면 102가 다시 들어옵니다. 저장 키가 없다면 거래량이 두 번 합산됩니다. 반대로 배타적 커서라고 지레짐작해 103을 요청했는데 API 자체가 102 다음부터 반환하는 방식이면 103 경계를 건너뛸 수도 있습니다.
안전한 기본값은 한 행 겹치게 가져오고 고유키로 멱등 저장하는 것입니다. Binance의 계정 체결 문서는 `fromId`를 지정하면 그 ID 이상을 반환한다고 명시합니다. 이처럼 포함 조건이 확인된 엔드포인트는 다음 요청을 마지막 ID로 보내되, 첫 행 중복이 정확히 한 번 나타나는지 감시하면 계약 변경도 빠르게 찾을 수 있습니다.
| API 경계 | 다음 요청 | 저장 후 검사 |
|---|---|---|
| 포함형 ID 커서 | 마지막 ID를 다시 요청 | 첫 행 중복 후 고유키 1건 유지 |
| 배타형 ID 커서 | 응답이 준 next cursor 사용 | 이전 최대와 새 최소 연결 확인 |
| 시간 커서 | 마지막 시각을 겹쳐 요청 | 같은 시각의 모든 고유 ID 합치기 |
| before·after 헤더 | 응답 헤더의 실제 커서 사용 | 방향과 종료 조건 별도 기록 |
timestamp 하나로는 같은 순간의 체결을 셀 수 없습니다
한 밀리초에 체결이 여러 건 생길 수 있습니다. 마지막 행의 시각에 7건이 있었는데 페이지가 그중 4건에서 잘렸다면, 다음 시작 시각을 1밀리초 더해 요청하는 코드는 나머지 3건을 영구 누락합니다. 시간은 구간 필터로 쓰고, 경계 안의 순서는 거래소가 제공하는 trade_id나 sequence로 결정해야 합니다.
고유 ID가 없다면 `market + event_time + price + size + side` 같은 복합키를 임시로 사용할 수 있지만 서로 같은 체결 두 건을 하나로 합칠 위험이 있습니다. 이 경우 원본 행 전체의 해시와 페이지 위치를 보관하고, 시간 경계를 넓게 겹쳐 받은 뒤 원 제공자의 중복 정의를 별도로 확인해야 합니다. 복합키는 보장된 식별자가 아니라 제한을 드러낸 차선책입니다.
- 원본 응답과 응답 헤더의 커서 값을 페이지 단위로 보관합니다.
- 시장 식별자와 거래 ID를 묶어 고유 제약조건을 설정합니다.
- 마지막 시간 경계를 다시 요청하고 같은 시각의 ID 집합을 합칩니다.
- 빈 페이지, 반복 커서, 최대 요청 횟수 초과를 정상 종료와 구분합니다.
숫자로 페이지 연결을 검산합니다
가상 수집에서 세 페이지의 원시 행 수가 각각 1,000건이고 경계 중복이 페이지 2와 3에 한 건씩 있다고 합시다. 원시 합계는 3,000건, 중복 키는 2건이므로 고유 체결은 `3,000 – 2 = 2,998건`입니다. 저장 결과가 2,997건이면 중복 제거 규칙이 한 건을 과도하게 합쳤거나 경계 체결을 놓친 것입니다. 이 수치는 방법 검산용 가정이며 실제 거래량이 아닙니다.
ID가 구간 안에서 20001부터 22998까지 매번 1씩 증가하도록 보장된 시장이라면 기대 건수는 `22998 – 20001 + 1 = 2,998건`입니다. 고유 저장 건수와 정확히 일치합니다. 일부 API는 ID가 시장 전체 기준이거나 내부 사건 때문에 건너뛸 수 있으므로, ID 연속성은 문서나 표본으로 확인된 경우에만 완전성 증거로 씁니다.
종료 조건과 재시작 지점을 데이터로 남깁니다
응답 행 수가 limit보다 적으면 끝이라고 가정하는 구현은 보관 정책, 일시적 서버 제한, 필터 적용 때문에 조기 종료할 수 있습니다. 공식 next cursor가 없고 시간 범위를 직접 움직인다면 요청 종료 시각을 넘었는지와 마지막 키가 더 이상 진전하지 않는지를 함께 봅니다. 동일 커서가 두 번 나오면 무한 루프를 끊고 오류로 기록합니다.
체크포인트에는 요청 파라미터만 두지 말고 마지막 확정 고유키, 마지막 이벤트 시각, 페이지 응답 해시, 원시·고유 행 수를 저장하세요. 재시작할 때 한 페이지를 겹쳐 다시 읽으면 직전 쓰기가 완료됐는지 모호해도 같은 결과로 수렴합니다. 네트워크 재시도와 데이터 경계 이동을 분리해야 재시도가 누락을 만들지 않습니다.
완료 보고에는 범위와 공백을 함께 적습니다
‘전체 수집 완료’는 페이지가 더 없다는 뜻만으로 부족합니다. 시장, 시작·종료 시각, 정렬 기준, 체결 건수, 총 원시 행, 고유 행, 중복 행, ID 공백 수를 함께 적어야 합니다. 문서상 ID 연속성이 보장되지 않으면 공백은 누락 확정이 아니라 조사 대상으로 표시합니다. 체결이 없던 시간과 API가 비어 있던 시간도 구분해야 합니다.
최종 집계 전에 첫 10건과 마지막 10건, 각 페이지 경계의 앞뒤 행을 표본으로 대조하세요. 이후 거래량을 계산할 때는 고유 저장 테이블만 사용하고 원시 페이지 합계를 더하지 않습니다. 이렇게 하면 재수집이나 실패 복구가 여러 번 일어나도 집계 결과가 바뀌지 않는 수집 파이프라인을 만들 수 있습니다.
자주 묻는 질문
페이지마다 limit만큼 왔으면 누락이 없다고 봐도 되나요?
아닙니다. 페이지 안 행 수가 가득 차도 경계 방향을 잘못 잡거나 같은 timestamp의 체결을 건너뛸 수 있습니다. 고유키와 경계 연결을 별도로 검사해야 합니다.
중복은 받은 뒤 전부 DISTINCT 처리하면 충분한가요?
거래소가 보장한 거래 ID를 기준으로 하면 안전합니다. 가격·수량·시각만 같은 서로 다른 체결까지 합치면 실제 거래를 지울 수 있으므로 임의 복합키의 한계를 기록해야 합니다.
실시간 수집 중 과거 페이지를 내려받아도 되나요?
가능하지만 기준 종료 시각을 먼저 고정하고 그 이전만 백필하세요. 계속 늘어나는 최신 구간을 역방향으로 읽으면 페이지 이동 중 새 체결이 끼어 결과가 흔들릴 수 있습니다.
더 깊이 읽기
본문에서 다룬 개념과 확인 절차를 다음 글에서 이어서 살펴보세요.